Cockroach Labs заставляет предприятия платить
Cockroach Labs, создатели CockroachDB, объявили об изменениях в модели лицензирования, направленных на то, чтобы заставить платить более крупных пользователей.

Стивен Вольфрам только что опубликовал в своем блоге очень длинную статью под названием «Что на самом деле происходит в машинном обучении? Некоторые минимальные модели». Возможно ли, что он знает?
На мой взгляд, нет, и, что еще более важно, он даже не может выйти на старт. Тем не менее, подход интересен, и это хорошее чтение.
Дело в том, что мы действительно уже знаем, почему работают нейронные сети, которые он подразумевает под «машинным обучением». Они представляют собой применение простого принципа оптимизации в сочетании с законом Эшби о необходимом разнообразии, который в основном гласит, что для успешной работы система должна быть такой же изменчивой или сложной, как и ее окружение. Это старый закон из ранних дней кибернетики, что же случилось с этим конкретным начинанием? Немного расширив его, можно сказать, что если система обладает определенным количеством степеней свободы, то любая система, которая надеется контролировать, имитировать или действовать в противовес ей, должна обладать таким же количеством степеней свободы или даже больше. Принцип оптимизации заключается в том, что если вы продолжаете двигать эти степени свободы в направлении «лучше», то в конце концов придете к приемлемому состоянию.
Глубокие нейронные сети - это системы с огромным количеством степеней свободы - настолько большим, что они сравнимы со степенями свободы, присущими реальному миру, или, по крайней мере, с ограниченным подмножеством таковых. Оптимизация происходит в форме обратного распространения, которое само по себе является лишь применением чуть более общего градиентного спуска. По сути, это работает путем вычисления производной системы, то есть нахождения того, как настроить параметры для уменьшения ошибки, и последующего движения в этом направлении. Градиентный спуск - это просто математическое выражение фразы «если вы продолжаете двигаться вниз по склону, то с большой вероятностью достигнете дна».
Это настолько мощные простые идеи, что можно быстро прийти к выводу, что если вы можете реализовать что-то в виде достаточно сложной дифференцируемой системы, то сможете обучить ее делать практически все, что угодно. Например, если вы можете изменить дискретный и недифференцируемый подход к программированию на что-то гладкое и дифференцируемое, то вы можете использовать градиентный спуск для обучения программированию, см. статью DeepCoder Learns To Write Programs.
В последнем блоге Вольфрам рассказывает о том, как использовать клеточные автоматы для изучения функций. Прежде чем перейти к этой теме, он показывает, как обучается стандартная нейронная сеть, сводя модель к чему-то достаточно простому, чтобы можно было проследить ее эволюцию. Это интересно, но не раскрывает того, что мы все действительно хотим знать - улавливает ли сеть некую «сущность» того, что она изучает, или она просто запоминает это, не сводя к чему-то более простому?
По-настоящему интересная часть блога, хотя она и не отвечает на вопрос, поставленный в самом начале, заключается в том, что нейронная сеть заменяется одномерными клеточными автоматами. В этом случае обучение происходит с помощью модифицированного генетического алгоритма. Этот алгоритм представляет собой дискретную версию принципа оптимизации, который работает без градиента. Это связано с тем, что понятие «производная» не существует в дискретных системах. Вместо этого алгоритм использует случайное исследование поверхности отклика.
Это эквивалентно спуску с холма путем пробного движения в каждом направлении, чтобы выяснить, какое из них «вниз», и затем двигаться в этом направлении. Вы находите градиент, исследуя близлежащую область.
Следующая идея - использовать клеточные автоматы, которые ограничены булевыми правилами, и варьировать эти правила, чтобы получить различные модели поведения. Вы можете вызвать обучение, выбрав набор правил, которые нужно применять по порядку - своего рода программу. Затем вы можете обучить их с помощью генетического алгоритма, чтобы достичь конечного результата. Угадайте, что? Это работает!
И снова принцип оптимизации в сочетании с триумфом Эшби. Стали ли мы ближе к пониманию того, почему нейронные сети так эффективны? Не совсем, но это весело.
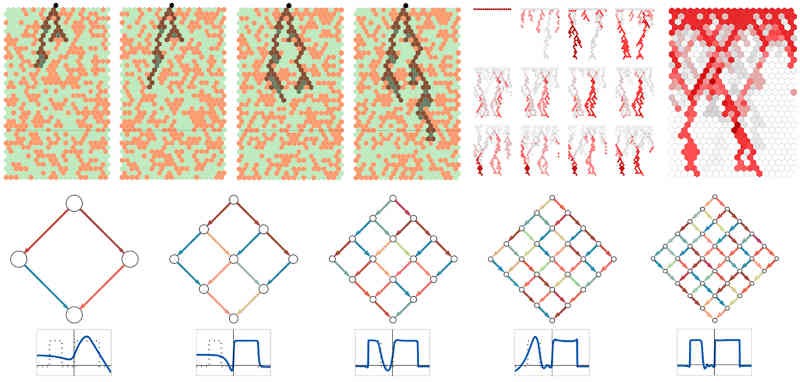
Вы также можете рассматривать «новые» сети клеточных автоматов как примеры сетей Колмогорова-Арнольда, KAN. Стандартные нейронные сети имеют фиксированный набор функций, реализуемых всеми нейронами, и обучение происходит путем изменения весов каждой функции. То, что такая сеть может научиться воспроизводить любую функцию, является следствием универсальной теории аппроксимации, которая гласит, что при правильном выборе функции сети даже очень простые функции могут быть настроены так, чтобы приблизиться к любой более общей функции. Теория представления Колмогорова-Арнольда говорит нечто подобное, но в этом случае мы используем разные функции на каждом нейроне. Если рассматривать правило как эквивалент функции, то это булева функция, тогда мы имеем KAN-сеть.
Далее блог пытается связать все это с принципом универсальных вычислений, который гласит, что практически любая система, которая не является тривиальной, с высокой вероятностью является полной по Тьюрингу - то есть способной вычислить что угодно. Все это правда, и если вы соедините принцип универсальных вычислений с принципом оптимизации и законом Эшби, все начнет обретать смысл. Мы все еще не приблизились к пониманию нейронных сетей, но эта статья в блоге интересна для чтения и заставляет задуматься, если только вы не считаете, что все, что вы читаете, является новым и не связано с другими исследованиями.
Настоящая проблема с нейронными сетями заключается не в том, как они обучаются - это довольно легко понять, и для этого даже есть достаточно хороший математический фундамент. Интересно то, как глубокая нейронная сеть представляет мир, на котором она обучается. Отражают ли кластеры, группировки и так далее в реальном мире структуры в обучаемой сети? И позволяют ли эти структуры обобщать? Ответьте на эти вопросы, и мы достигнем прогресса.
Cockroach Labs, создатели CockroachDB, объявили об изменениях в модели лицензирования, направленных на то, чтобы заставить платить более крупных пользователей.
В знак своего намерения использовать новые полномочия, предоставленные Законом о цифровых рынках, конкуренции и потребителях (DMCCA), Управление по конкуренции и рынкам (CMA) завершило расследование в отношении Play Store компании Google и App Store компании Apple.
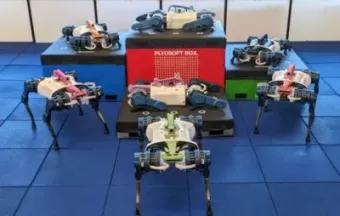
Проект Barkour от Google-DeepMind расширяет границы робототехники, создавая роботов, которые могут сравниться или даже превзойти по ловкости настоящих собак.