Microsoft улучшает контрастность текста для всех браузеров Windows Chromium
Microsoft заявляет, что улучшила контрастность текста, отображаемого во всех веб-браузерах на базе Chromium под Windows, сделав его более читаемым на некоторых дисплеях.

Core, новое предложение InfluxDB с открытым исходным кодом, обещает повышенную производительность и большую свободу использования в соответствии с разрешительной лицензией.
В прошлом мы уже косвенно знакомились с Influx на примере сервиса Amazon Timestream, полностью управляемой службы баз данных временных рядов, которая основана на InfluxDB с открытым исходным кодом. В той статье мы также дали формальное определение временных рядов:
Временной ряд - это последовательность точек данных, представленных через последовательный интервал времени.
Некоторые общие случаи использования базы данных временных рядов:
Примеры практического применения:
Новость заключается в том, что InfluxDB 3 Core, продукт с открытым исходным кодом и двойной лицензией MIT или Apache 2, а также InfluxDB 3 Enterprise были выпущены в статусе Alpha.
По сути, Core - это переработанный открытый исходный код Influx с целью обеспечения более высокой производительности, запросов в реальном времени и быстрого ввода данных, а также других возможностей.
Поскольку Core позволяет выполнять запросы к данным за последние 72 часа, он оптимизирован для работы с передовыми данными временных рядов, а также для аналитических запросов, что позволяет достичь сверхбыстрого времени отклика.
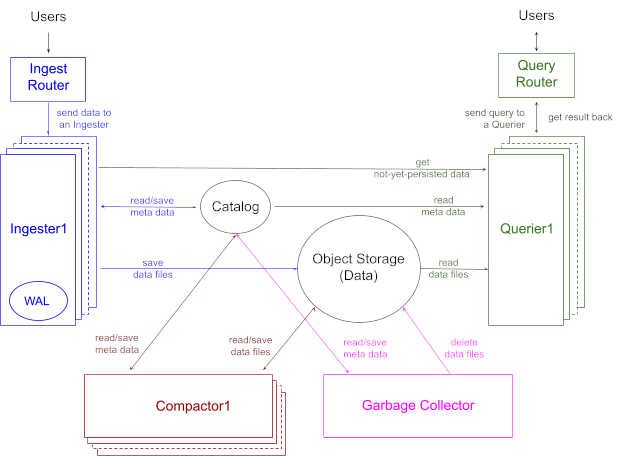
Если вы хотите обновить базу данных, но при этом сохранить код приложения в прежнем виде, не беспокойтесь: Core также будет поддерживать API записи InfluxDB 1.x и 2.x.
Помимо поддержки совместимости, к особенностям InfluxDB 3 Core относятся:
Что касается версии Enterprise, то она опирается на функциональность Core и добавляет:
InfluxDB 3 Core уже сейчас доступен для тестирования и обратной связи, но он не предназначен для использования в производстве. В еще более экспериментальном статусе находится новая система плагинов, позволяющая пользователям определять Python-скрипты, которые могут собирать, обрабатывать, преобразовывать и отслеживать данные на лету прямо в базе данных. Когда она будет готова, это станет находкой для специалистов по исследованию данных, работающих с потоковыми данными временных рядов.
Так что если вы хотите испытать все новые возможности, берите и собирайте программное обеспечение из его репозитория на Github. Он также доступен в виде образа docker для более простой установки. Но, как уже говорилось, поскольку это еще альфа-версия, будьте осторожны.
Microsoft заявляет, что улучшила контрастность текста, отображаемого во всех веб-браузерах на базе Chromium под Windows, сделав его более читаемым на некоторых дисплеях.
Вышла версия Bun 1.2, в которой появились улучшения, в том числе совместимость с Node.js, встроенный API для хранения объектов S3 и встроенный клиент Postgres.
SQLite живет в браузере благодаря WebAssembly.