Результатом этого сотрудничества стало расширение pg_duckdb, которое встраивает движок DuckDB в базу данных PostgreSQL, позволяя ей справляться с аналитическими нагрузками.
В современную эпоху рабочих нагрузок, ориентированных на данные, инженеры-программисты обычно жонглируют множеством разрозненных источников данных, используя множество различных инструментов для разработчиков. А что, если бы у вас был один инструмент, который бы управлял всеми ими? Такой инструмент существует и называется Postgres; он действительно может справиться со всем, что вы ему предложите.
Новость заключается в том, что, благодаря партнерству MotherDuck и Hydra, PostgreSQL теперь готов к OLAP+OLTP = HTAP.
С другой стороны, готовность к HTAP не является чем-то новым для PostgreSQL, о чем мы уже писали в статье «Hydra Turns PostgreSQL Into A Column Store». Это расширение с открытым исходным кодом, которое добавляет в Postgres таблицы с колонками для эффективной аналитической отчетности, позволяя ему стать готовым к HTAP, поддерживая как транзакционные, так и аналитические рабочие нагрузки для обеспечения доступа к данным и их анализа в режиме реального времени в одной системе.
Хотя с момента создания Hydra PostgreSQL мог справляться с аналитическими нагрузками, передача аналитического механизма DuckDB обеспечивает оптимизированную производительность плюс возможность чтения и записи файлов на внешних объектных хранилищах, таких как AWS и S3, что становится идеальным вариантом для запросов к данным в Data Lakes.
На этом этапе важно отметить, что интеграция PostgreSQL с DuckDB не является чем-то новым. Это уже было свойством другого расширения pg_lakehouse (теперь pg_analytics) от ParadeDB, которое мы рассматривали в статье «Pg_lakehouse Makes PostgreSQL Quack». Там мы обнаружили, что :
Запросы спускаются в DuckDB для обработки таких данных, как события, метрики, исторические снимки, данные о поставщиках, но это одна часть уравнения, механизм запросов. Другая - это возможность получать данные из внешних хранилищ объектов, таких как S3, и форматов таблиц, таких как Iceberg или Delta Lake.
Так в чем же разница между pg_analytics и pg_duckdb, скажете вы. Оба используют API-обертку для иностранных данных (FDW) для подключения к этим разрозненным источникам данных, но обертка для иностранных данных pg_analytics построена на Rust, а pg_duckdb - на C++. Кроме того, pg_duckdb является официально одобренным расширением PostgreSQL для DuckDB, что подразумевает лучшую поддержку и реализацию возможностей?
И это не только pg_analytics, но и pg_mooncake! Так что на самом деле существует три расширения, взаимодействующих с DuckDB!
И теперь проблема начинает показывать свою уродливую голову. Все эти три расширения встраивают свои собственные сборки libduckdb (DuckDB как библиотека, как и Sqlite. DuckDB FDWs зависит от нее), что становится проблемой, как подчеркивает эта проблема, поднятая на Githb, в том, что :
Встраивание libduckdb требует значительного времени компиляции и приводит к резкому увеличению размера пакета. Эта проблема усугубляется, если рассматривать комбинацию для 3 основных версий PostgreSQL и 5 дистрибутивов ОС, к тому же одновременная установка этих расширений нецелесообразна.
В качестве исправления предлагается использовать общую библиотеку libduckdb, которая может значительно сократить время компиляции и размер пакета, а также устранить конфликты расширений.
Но хватит уже говорить, просто покажите мне, на что способен pg_duckdb!
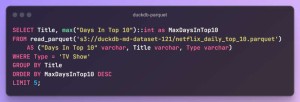
Конечно. Например, следующий запрос использует pg_duckdb для запроса файлов Parquet, хранящихся в S3, чтобы найти лучшие телевизионные шоу в США в 2020-2022 годах.
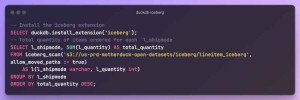
Затем вы можете читать из таблицы Iceberg:
Конечно, вы также можете записывать данные в свое озеро данных и так далее.
Что касается установки, на Dockerhub доступны образы Docker, основанные на официальном образе Postgres:
docker run -d -e POSTGRES_PASSWORD=duckdb pgduckdb/pgduckdb:16-main
Предварительно собранные двоичные файлы, доступные через pgxman:
pgxman install pg_duckdb
Или, если вы чувствуете себя достаточно храбрым, скомпилируйте из исходников, клонировав репо на Github.
В заключение. Мы описали причины перехода на Postgres в статье «Сейчас 2024 год. Почему PostgreSQL все еще доминирует?». С тех пор появилась лавина новых разработок, которые прочно закрепили Postgres на первом месте в сердцах разработчиков.
В ответ на такую заботу Postgres процветающее сообщество разработчиков PostgreSQL отвечает взаимностью, придумывая всевозможные новые идеи, направленные на его совершенствование. Конечно, в этом нет ничего неожиданного, ведь PostgreSQL с самого начала своего существования создавался с расчетом на большую расширяемость.
И именно так, дамы и господа, можно создать продукт, который будет жить веками...