Microsoft Research учит инструменты ИИ отлаживать код
Microsoft Research представила debug-gym - новую среду, предназначенную для обучения ИИ-инструментов кодирования сложному искусству отладки кода.

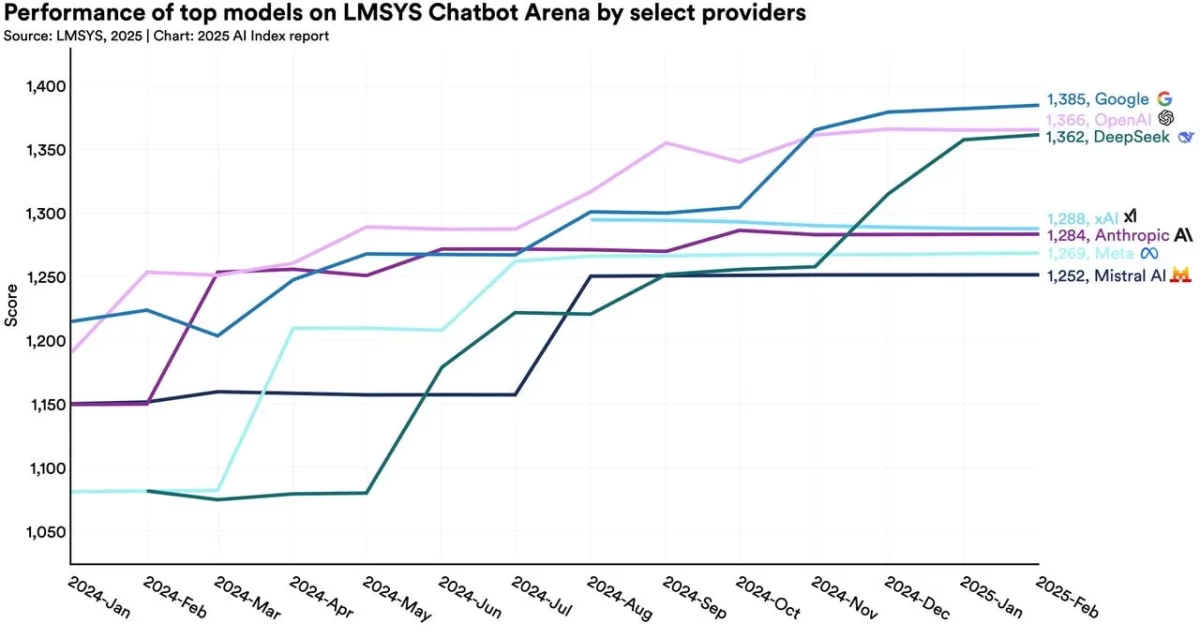
Соревнование за создание ведущей модели ИИ превратилось в схватку. Кто из претендентов, скорее всего, заменит OpenAI и Google на вершине кучи?
Соревнование за создание лучших в мире моделей искусственного интеллекта превратилось в нечто похожее на схватку: куча достойных претендентов, наброшенных друг на друга, и все меньше шансов на чью-либо победу.
По мнению ученых из Института человекоцентрированного искусственного интеллекта Стэнфордского университета, за последние годы число претендентов на «пограничные» или «базовые» модели значительно увеличилось, но и разница между лучшими и слабейшими существенно сократилась.
В 2024 году «разница в баллах Эло между моделью, занимающей первое и десятое места в рейтинге Chatbot Arena Leaderboard, составляла 11,9 %. К началу 2025 года этот разрыв сократился до 5,4 %», - пишут Риши Боммасани и его коллеги в „Ежегодном отчете The AI Index 2025“.
В главе, посвященной техническим характеристикам, Боммасани и его коллеги отмечают, что в 2022 году, когда только появился ChatGPT, в топе крупных языковых моделей доминировали OpenAI и Google. Теперь в эту область входят китайский DeepSeek AI, xAI Элона Маска, Anthropic, Meta Platforms's Meta AI и Mistral AI.
«Ландшафт ИИ становится все более конкурентным, высококачественные модели теперь доступны все большему числу разработчиков», - пишут они.
Разрыв между OpenAI и Google сократился еще больше: разница в производительности семейства GPT и Gemini составляет всего 0,7 %, в то время как в 2023 году она составляла 4,9 %.
Одновременной тенденцией, по словам Боммасани, является рост «открытых» моделей ИИ, таких как Llama от Meta Platforms, которые в некоторых случаях могут сравниться с лучшими «закрытыми» моделями, такими как GPT.
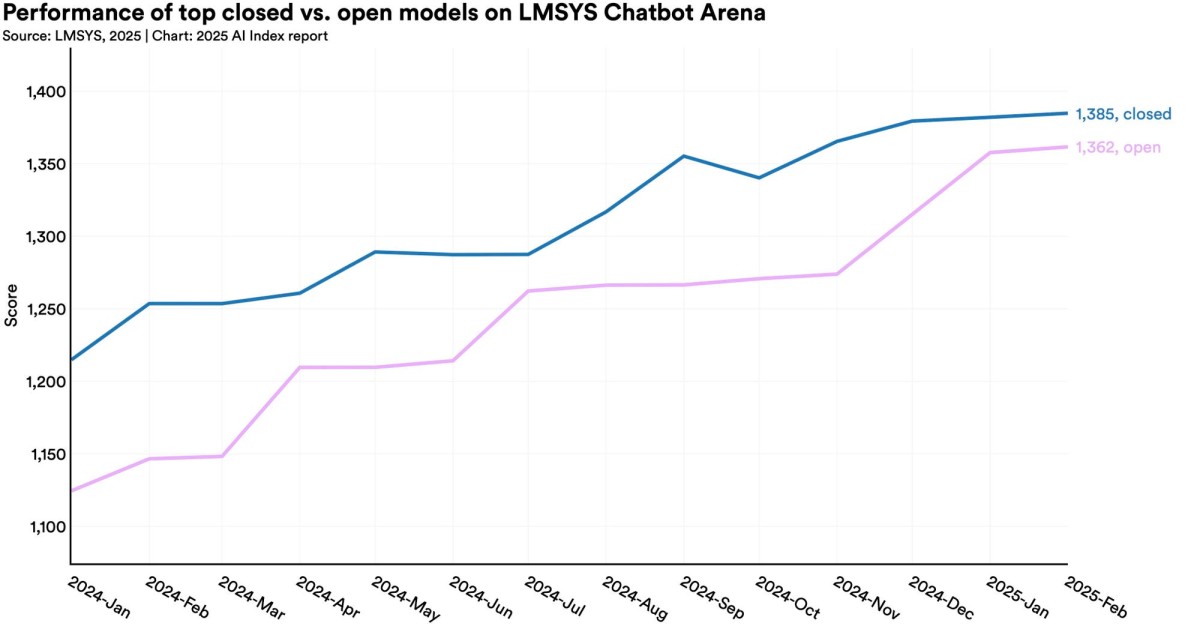
Модели с открытым весом - это модели, в которых обученные веса нейронных сетей, являющиеся основой их способности преобразовывать входные данные в выходные, доступны для скачивания. Их можно использовать для проверки и воспроизведения модели ИИ, не имея доступа к исходному коду модели. Закрытые модели не предоставляют публичного доступа к весам, поэтому модели остаются чем-то вроде черного ящика, как в случае с GPT и Gemini.
«В начале января 2024 года ведущая закрытая модель опережала ведущую открытую модель на 8,0 %. К февралю 2025 года этот разрыв сократился до 1,7 %», - пишут Боммасани и его коллеги.
С 2023 года, когда «модели с закрытым весом постоянно превосходили аналоги с открытым весом почти по всем основным бенчмаркам», разрыв между закрытыми и открытыми моделями сократился с 15,9 пункта до «всего 0,1 процентного пункта» в конце 2024 года, в основном благодаря версии 3.1 Llama от Meta.
Наряду с моделями с открытым весом, в последнее время все чаще встречаются удивительные достижения небольших крупных языковых моделей. Модели ИИ обычно классифицируются по количеству используемых ими весов, и самая большая из них - Llama 4 компании Meta - использует два триллиона весов.
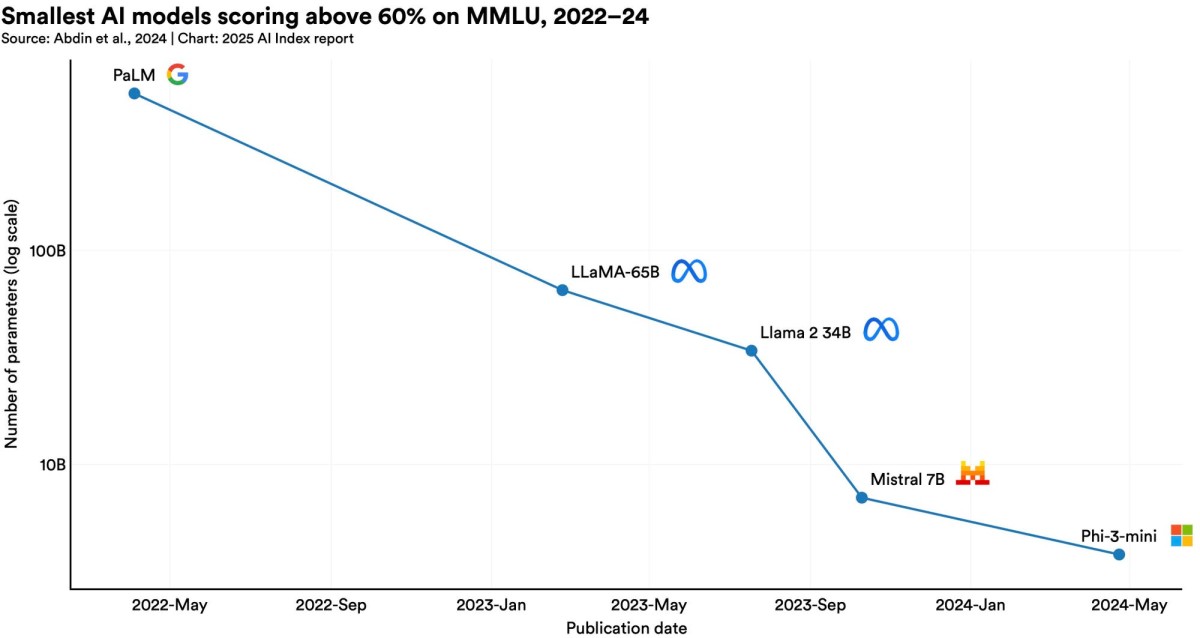
«2024 год стал прорывным для небольших моделей ИИ», - пишут Боммасани и команда. «Почти каждый крупный разработчик ИИ выпустил компактные и высокопроизводительные модели, включая GPT-4o mini, o1-mini, Gemini 2.0 Flash, Llama 3.1 8B и Mistral Small 3.5».
Боммасани и его коллеги не делают никаких прогнозов относительно того, что произойдет дальше в этой переполненной области, но они видят очень актуальную проблему для эталонных тестов, используемых для оценки больших языковых моделей.
Эти тесты становятся все более насыщенными - даже некоторые из самых требовательных, такие как бенчмарк HumanEval, созданный в 2021 году OpenAI для проверки навыков кодирования моделей. Это подтверждает то, что сейчас ощущается во всей индустрии: Становится все труднее точно и строго сравнивать новые модели ИИ.
В ответ на это, отмечают авторы, в данной области были разработаны новые способы построения эталонных тестов, такие как Humanity's Last Exam, в котором вопросы составляются людьми и экспертами; Arena-Hard-Auto, тест, созданный некоммерческой компанией Large Model Systems Corp., в котором используются подсказки из толпы, автоматически определяемые по степени сложности.
Авторы отмечают, что одним из самых сложных тестов является тест ARC-AGI на поиск визуальных паттернов. Это по-прежнему сложный тест, даже несмотря на то, что o3 mini от OpenAI отлично справился с ним в декабре.
Сложность теста влияет на модели ИИ в лучшую сторону, пишут они. «Улучшения этого года [o3 mini] свидетельствуют о смещении фокуса в сторону более значимых достижений в обобщении и возможностях поиска» среди моделей ИИ, пишут они.
Авторы отмечают, что создание эталонов - дело непростое. Например, существует модель «заражения», когда нейронные сети обучаются на данных, которые в итоге используются в качестве тестовых вопросов, подобно студенту, получившему доступ к ответам перед экзаменом.
А многие эталоны просто плохо построены, пишут они. «Несмотря на широкое распространение, такие эталоны, как MMLU, продемонстрировали плохое соблюдение стандартов качества, в то время как другие, например GPQA, показали себя значительно лучше», - говорится в обширном исследовании Стэнфорда под названием BetterBench.
Боммасани и его коллеги пришли к выводу, что стандартизация эталонов необходима в будущем. «Эти результаты подчеркивают необходимость стандартизированных бенчмарков для обеспечения надежной оценки ИИ и предотвращения ошибочных выводов о производительности моделей», - пишут они. «Эталоны могут определять политические решения и влиять на решения о закупках в организациях, что подчеркивает важность последовательности и строгости в оценке».
Microsoft Research представила debug-gym - новую среду, предназначенную для обучения ИИ-инструментов кодирования сложному искусству отладки кода.
Развитие искусственного интеллекта переходит на новый важный этап: появляются агенты ИИ, способные получать свежую информацию из Интернета, планировать и выполнять задачи в автономном режиме.
Google представила новые инструменты ИИ Gemini для корпоративных пользователей в Android Studio, разработанные с учетом требований конфиденциальности, безопасности и управления.