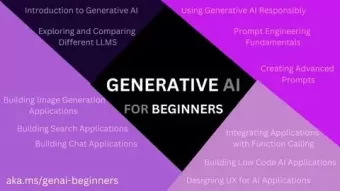
Генеративный ИИ от Microsoft для начинающих Версия 2
Вышла обновленная версия бесплатного самостоятельного онлайн-курса Microsoft Azure Cloud Advocates по генеративному искусственному интеллекту.

OSI и союзники стали на шаг ближе к открытому определению искусственного интеллекта, и пуристы не единственные, кто недоволен.
Добиться единства открытого исходного кода и искусственного интеллекта (ИИ) не так-то просто. Спросите у Open Source Initiative (OSI). OSI, организация, управляющая определением открытого исходного кода, работает над созданием определения искусственного интеллекта с открытым исходным кодом уже два года. Однако группа добилась определенного прогресса. Ее Open Source AI Definition уже выпустила свой первый релиз-кандидат RC1.
Последнее определение призвано прояснить зачастую спорные дискуссии вокруг ИИ с открытым исходным кодом. Оно определяет четыре фундаментальные свободы, которые должны быть предоставлены системе ИИ, чтобы считаться открытым исходным кодом: возможность использовать систему в любых целях без разрешения, изучать, как она работает, модифицировать ее для любых целей и делиться ею с изменениями или без них.
Пока все хорошо.
Однако в отношении учебных данных OSI пошла на компромисс. Признавая, что делиться полными наборами данных непросто, текущее определение требует «достаточно подробной информации о данных, использованных для обучения системы», а не самого полного набора данных. Такой подход направлен на обеспечение баланса между прозрачностью и практическими и юридическими соображениями.
Последнюю фразу некоторым людям трудно проглотить. С их точки зрения, если все данные не открыты, то основанные на них большие языковые модели (LLM) ИИ не могут быть с открытым исходным кодом.
OSI обобщила эти аргументы следующим образом: «Некоторые люди считают, что полный, неограниченный доступ ко всем обучающим данным (без различия их вида) имеет первостепенное значение, утверждая, что меньшее поставит под угрозу полную воспроизводимость систем ИИ, прозрачность и безопасность. Такой подход низведет ИИ с открытым исходным кодом в нишу ИИ, обучаемого только на открытых данных».
Они не ошибаются.
Да, в идеале OSI согласна с тем, что все данные для обучения должны быть общими и открытыми. Однако существует четыре различных типа данных: открытые, общедоступные, получаемые и необщедоступные данные. «Для каждого из них существуют свои юридические требования. Все они должны предоставляться в той форме, в которой закон позволяет их предоставлять».
Короче говоря, «данными бывает трудно поделиться. Законы, разрешающие обучение на данных, часто ограничивают повторное распространение этих данных для защиты авторских прав или других интересов. Правила конфиденциальности также дают человеку право контролировать свою наиболее чувствительную информацию - например, решения о своем здоровье».
Релиз-кандидат также затрагивает другие ключевые компоненты систем искусственного интеллекта. Он требует, чтобы полный исходный код, используемый для обучения и работы системы, был доступен по лицензиям, одобренным OSI. Аналогичным образом, параметры и веса моделей должны предоставляться на открытых условиях.
Стефано Маффулли, исполнительный директор OSI, подчеркнул важность этого определения для борьбы с «открытым мытьем» - практикой, когда компании заявляют о своей открытости, не соблюдая истинных стандартов открытого кода. «Если компания заявляет, что она с открытым исходным кодом, она должна нести ценности, которые несет в себе определение открытого исходного кода. В противном случае это просто сбивает с толку».
В интервью на Open Source Summit Europe в Вене, Австрия, Мафулли сказал мне, что не только пуристы открытого исходного кода недовольны предложенным определением OSI AI. Другие «это корпорации, которые считают свои схемы обучения и то, как они проводят обучение, собирают и фильтруют наборы данных и создают наборы данных, коммерческой тайной. Они не хотят их раскрывать. Они считают, что мы просим слишком многого. Это старый аргумент, который мы слышали в 90-х годах, когда Microsoft не хотела выпускать свой исходный код или инструкции по сборке».
Кроме того, в RC1 появились две новые функции. Первая заключается в том, что код ИИ с открытым исходным кодом должен быть достаточным для того, чтобы последующие получатели могли понять, как происходило обучение на машинном языке. Обучение - это то место, где происходят инновации, и, по словам OSI, именно «поэтому вы не видите, чтобы корпорации выпускали свой код обучения и обработки данных». Учитывая текущее состояние знаний и практики, это необходимо для значимого развития систем ИИ.
Наконец, новый текст признает, что создатели могут явно требовать условия авторского лева для кода, данных и параметров ИИ с открытым исходным кодом, как по отдельности, так и в виде комбинаций. В качестве примера можно привести ситуацию, когда «консорциум, владеющий правами на обучающий код и набор данных, решил распространять код и данные в связке с юридическими условиями, которые связывают их вместе, с положениями, подобными авторскому леву».
И далее OSI продолжает: «Такого рода юридического документа пока не существует, но сценарий достаточно правдоподобен, чтобы заслуживать рассмотрения».
Не думайте, что с определением уже покончено. Это не так. Правда, OSI не планирует добавлять новые функции. В дальнейшем они и их партнеры будут работать над исправлением ошибок. OSI признает, что все еще могут быть «серьезные недостатки, которые могут потребовать значительного переписывания текста». Однако основное внимание будет уделено сопроводительной документации.
Кроме того, OSI «осознала, что в своем рвении решить проблему данных, которые должны быть предоставлены, но не могут быть предоставлены владельцем модели по уважительным причинам, мы не смогли четко сформулировать основное требование: „Если вы можете поделиться данными, вы должны это сделать“».
Если все пройдет гладко, OSI планирует выпустить финальную версию 1.0 Open Source AI Definition на конференции All Things Open 28 октября 2024 года. Держитесь крепче, друзья. Мы к этому идем.
Вышла обновленная версия бесплатного самостоятельного онлайн-курса Microsoft Azure Cloud Advocates по генеративному искусственному интеллекту.
Компания Microsoft представила Azure AI Inference SDK для .NET.
Эссе Альтмана идет вразрез с интеллектуальной критикой ограничений ИИ и опасениями по поводу экологических и социальных потрясений.