Мы проигрываем битву со сложностью, и ИИ может помочь, а может и нет
Мыслители и исполнители в разных отраслях согласны с тем, что ИИ - это обоюдоострый меч, который снижает сложность и одновременно повышает ее.

Модель искусственного интеллекта, потрясшая мир, является частью широкой тенденции по выжиманию большего из чипов с помощью так называемой разреженности.
Рынок искусственного интеллекта - и весь фондовый рынок - в понедельник был потрясен внезапной популярностью DeepSeek, открытой модели большого языка, разработанной китайским хедж-фондом, которая по некоторым задачам превзошла лучшую модель OpenAI и при этом обошлась гораздо дешевле.
Как сообщила в понедельник Радхика Раджкумар из ZDNET, успех R1 свидетельствует об изменениях в области ИИ, которые могут дать возможность небольшим лабораториям и исследователям создавать конкурентоспособные модели и разнообразить спектр доступных возможностей.
Оказывается, это широкий подход к глубокому обучению в искусственном интеллекте, позволяющий выжать больше из компьютерных чипов за счет использования явления, известного как «разреженность».
Разреженность проявляется в разных формах. Иногда она включает в себя удаление части данных, которые использует ИИ, когда эти данные не оказывают существенного влияния на результаты работы модели ИИ.
В других случаях речь может идти о вырезании целых частей нейронной сети, если это не влияет на конечный результат.
DeepSeek - пример последнего: экономное использование нейросетей.
Главное достижение DeepSeek, которое многие отметили, заключается в том, что он может включать и выключать большие участки «весов», или «параметров», нейронной сети. Именно параметры определяют, как нейронная сеть может преобразовать входные данные - набранный вами запрос - в сгенерированный текст или изображение. Параметры оказывают непосредственное влияние на время, необходимое для выполнения вычислений. Чем больше параметров, тем больше вычислительных усилий, как правило.
Возможность использовать только некоторые параметры большой языковой модели и отключать остальные - это пример разреженности. Такая разреженность может существенно повлиять на то, насколько велик или мал бюджет вычислений для модели ИИ.
Исследователи ИИ из Apple в своем отчете, опубликованном на прошлой неделе, хорошо объясняют, как DeepSeek и подобные подходы используют разреженность для получения лучших результатов при заданном объеме вычислительных мощностей.
Apple не имеет отношения к DeepSeek, но Apple регулярно проводит собственные исследования в области ИИ, поэтому разработки сторонних компаний, таких как DeepSeek, являются частью постоянного участия Apple в области исследований ИИ, в широком смысле.
В статье, озаглавленной «Параметры против FLOPs: Scaling Laws for Optimal Sparsity for Mixture-of-Experts Language Models», опубликованной на сервере препринтов arXiv, ведущий автор Самир Абнар из Apple и другие исследователи Apple вместе с сотрудником Харшаем Шахом из Массачусетского технологического института изучали, как меняется производительность, когда они используют разреженность, отключая части нейронной сети.
Абнар и его команда провели свои исследования, используя библиотеку кода, выпущенную в 2023 году исследователями ИИ из Microsoft, Google и Стэнфорда, под названием MegaBlocks. Тем не менее, они дают понять, что их работа применима к DeepSeek и другим недавним инновациям.
Абнар и команда задаются вопросом, существует ли «оптимальный» уровень разреженности в DeepSeek и подобных моделях, то есть, при заданном объеме вычислительной мощности, существует ли оптимальное количество нейронных весов, которые нужно включать или выключать?
Оказывается, можно полностью оценить разреженность как процент всех нейронных весов, которые можно отключить, причем этот процент приближается к 100%, но никогда не равен 100% «неактивности» нейронной сети.
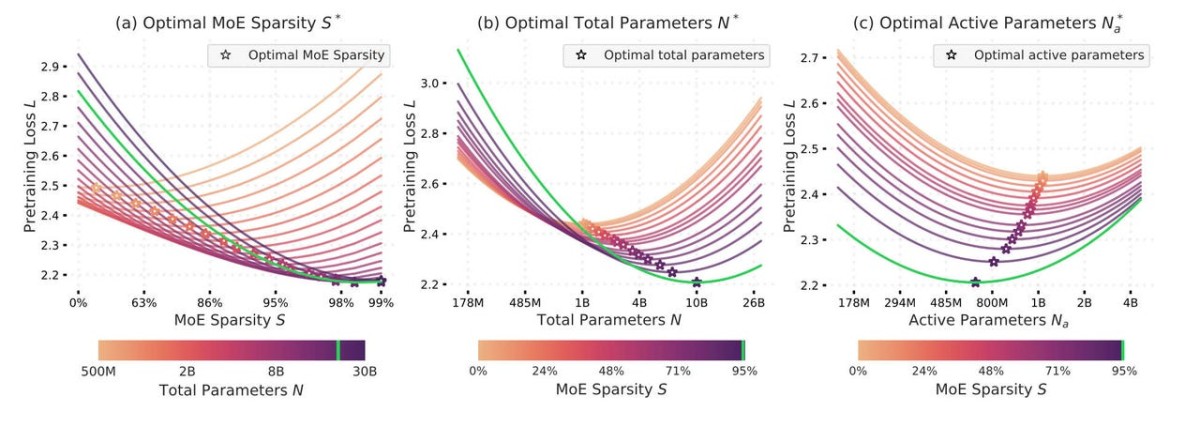
Графики показывают, что для данной нейронной сети при данном объеме вычислительного бюджета существует оптимальное количество нейронной сети, которое можно отключить, чтобы достичь определенного уровня точности. Это то же самое экономическое правило, которое было верно для каждого нового поколения персональных компьютеров: Либо лучший результат за те же деньги, либо тот же результат за меньшие деньги.
Оказалось, что для нейронной сети заданного размера с заданным количеством параметров при заданном объеме вычислительных ресурсов требуется все меньше и меньше параметров, чтобы достичь такой же или лучшей точности в заданном эталонном тесте ИИ, например в математике или ответах на вопросы.
Другими словами, какова бы ни была ваша вычислительная мощность, вы можете все чаще отключать отдельные части нейронной сети и получать те же или лучшие результаты.
Как выразились Абнар и его команда, «увеличение разреженности при пропорциональном увеличении общего числа параметров неизменно приводит к снижению потерь при предварительном обучении, даже если бюджет на вычисления при обучении фиксирован». Термин «потери при предварительном обучении» - это термин ИИ, обозначающий точность нейронной сети. Меньшие потери при обучении означают более точные результаты.
Этот вывод объясняет, как DeepSeek может иметь меньшую вычислительную мощность, но достигать такого же или лучшего результата, просто отключая все больше и больше частей сети.
Разброс - это своего рода волшебный циферблат, который находит наилучшее соответствие между имеющейся у вас моделью ИИ и доступными вам вычислительными мощностями.
Это то же самое экономическое правило, которое было верно для каждого нового поколения персональных компьютеров: Либо лучший результат за те же деньги, либо тот же результат за меньшие деньги.
Есть и другие детали, которые следует учитывать при работе с DeepSeek. Например, еще одним новшеством DeepSeek, как хорошо объяснил Эге Эрдил из Epoch AI, является математический трюк под названием «многоголовое скрытое внимание». Если не вдаваться в подробности, многоголовое скрытое внимание используется для сжатия одного из самых больших потребителей памяти и пропускной способности - кэша памяти, в котором хранится последний введенный текст подсказки.
Если отбросить детали, то наиболее важным моментом во всем этом является то, что разреженность как явление не является чем-то новым в исследованиях ИИ, равно как и новым подходом в инженерии.
Исследователи ИИ уже много лет показывают, что удаление частей нейронной сети позволяет добиться сопоставимой или даже лучшей точности при меньших усилиях.
Конкурирующая с Nvidia компания Intel уже не первый год называет разреженность ключевым направлением исследований, способным изменить положение дел в этой области. Подходы стартапов, основанные на разреженности, в последние годы также демонстрируют высокие результаты в отраслевых бенчмарках.
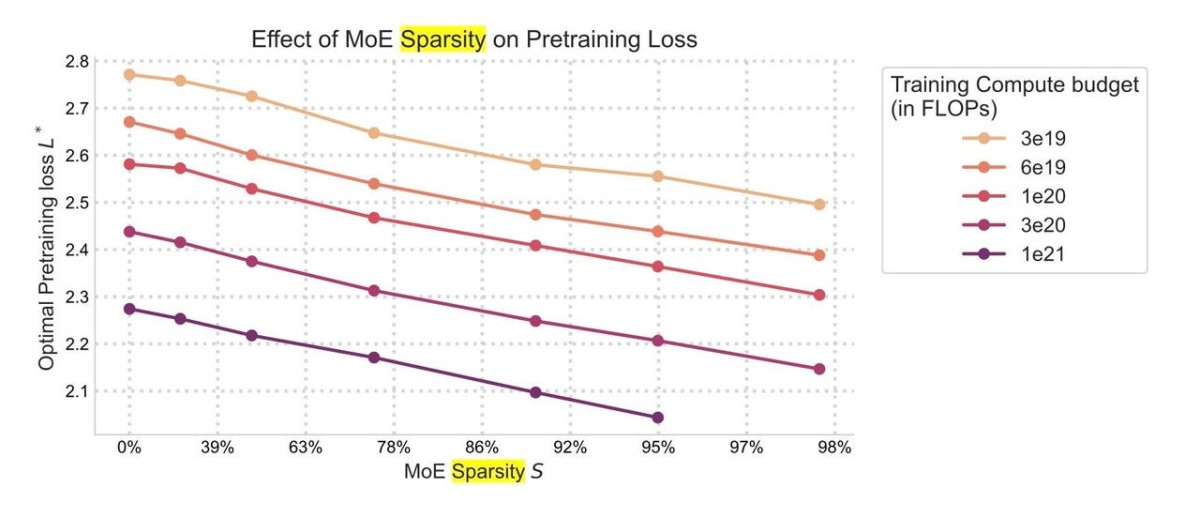
Магический циферблат разреженности не только снижает затраты на вычисления, как в случае с DeepSeek, но и работает в другом направлении: он может сделать все более и более крупные компьютеры ИИ более эффективными.
Магический циферблат разреженности очень глубок, потому что он не только улучшает экономику при небольшом бюджете, как в случае с DeepSeek, но и работает в обратном направлении: Потратьте больше, и вы получите еще больше преимуществ за счет разреженности. Абнар и его коллеги обнаружили, что по мере увеличения вычислительной мощности повышается точность модели ИИ.
По их словам, «с увеличением разреженности потери при проверке уменьшаются для всех бюджетов вычислений, при этом большие бюджеты дают меньшие потери на каждом уровне разреженности».
Теоретически, таким образом, вы можете создавать все более крупные модели на все более крупных компьютерах и получать все более выгодные результаты.
Вся эта работа с разреженностью означает, что DeepSeek - лишь один из примеров широкой области исследований, которой уже занимаются многие лаборатории и которую теперь будут развивать многие другие, чтобы повторить успех DeepSeek.
Мыслители и исполнители в разных отраслях согласны с тем, что ИИ - это обоюдоострый меч, который снижает сложность и одновременно повышает ее.
В связи с анонсом бесплатной версии GitHub Copilot мы более подробно рассматриваем последние события.
Согласно новому отчету консалтингового гиганта Deloitte, спустя три месяца после предыдущего опроса руководителей информационных служб, последние данные показывают, что большинство компаний не готовы к запуску в производство генеративного искусственного интеллекта (Gen AI).